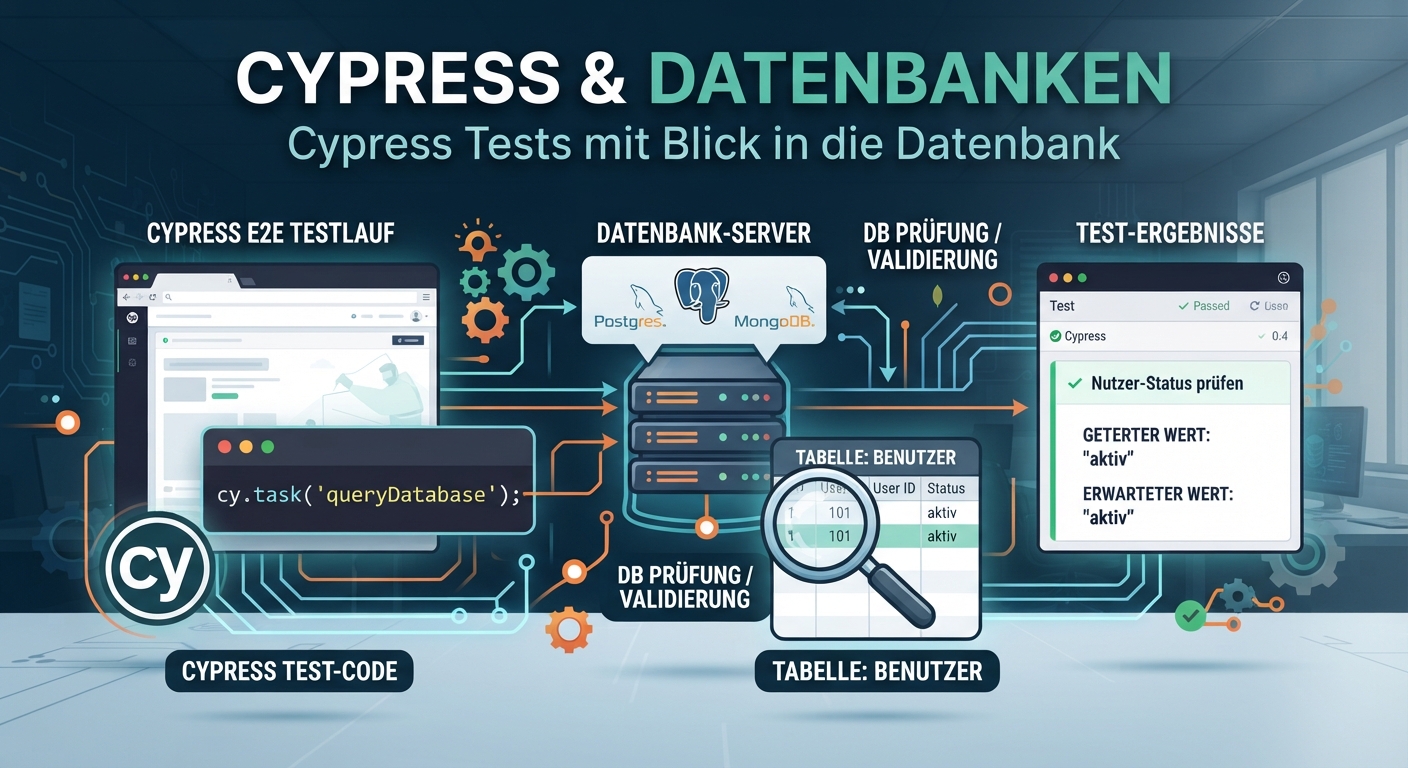
Cypress ermöglicht uns, Webanwendungen aus Sicht eines Benutzers zu testen. Doch manchmal reicht der Blick auf die Benutzeroberfläche nicht aus. Mit einem kontrollierten Datenbankzugriff können wir zusätzlich prüfen, was hinter der Oberfläche tatsächlich passiert.
Beim Testen einer Webanwendung konzentrieren wir uns häufig auf das, was ein Benutzer sieht und mit der Anwendung macht. Wir öffnen eine Seite, füllen ein Formular aus, klicken einen Button und prüfen anschließend, ob die erwartete Meldung erscheint.
Für viele Tests reicht das vollkommen aus.
Nehmen wir beispielsweise einen Onlineshop. Ein Kunde legt ein Produkt in den Warenkorb und schließt anschließend die Bestellung ab. Cypress kann prüfen, ob nach dem Klick auf „Bestellung abschicken“ die erwartete Bestätigungsseite erscheint:
Produkt auswählen
       ↓
Warenkorb
       ↓
Checkout
       ↓
Bestellung abschicken
       ↓
"Bestellung erfolgreich"
Aber wurde die Bestellung tatsächlich korrekt gespeichert? Existiert der Kunde in der Datenbank? Wurde die richtige Bestellung angelegt? Enthält sie das richtige Produkt? Stimmt der Gesamtbetrag? Hat die Bestellung den erwarteten Status?
Hier kann es sinnvoll sein, zusätzlich einen Blick in die Datenbank zu werfen.
In diesem Beitrag bauen wir deshalb einen kleinen Cypress-Test für einen beispielhaften Onlineshop auf. Wir schauen uns an, wie Cypress mit einer Datenbank kommunizieren kann, wie wir Testdaten vorbereiten und wie wir UI-Tests mit Datenbankprüfungen kombinieren.
Dabei geht es aber nicht nur um die technische Umsetzung. Ebenso wichtig ist die Frage:
Wann ist ein Datenbankzugriff im Cypress-Test sinnvoll – und wann vermischen wir damit eigentlich unterschiedliche Testebenen?
Unser Beispiel: Ein kleiner Onlineshop
Für die Beispiele verwenden wir einen einfachen Onlineshop.
Unser Shop besitzt Kunden, Produkte und Bestellungen. Eine Bestellung besteht wiederum aus mehreren Bestellpositionen.
Vereinfacht sieht unser Datenmodell so aus:
customers
---------
id
email
firstname
lastname


products
--------
id
name
price
stock


orders
------
id
customer_id
status
total
created_at


order_items
-----------
id
order_id
product_id
quantity
price
Eine Bestellung könnte beispielsweise so aussehen:
Customer
   │
   │ 1:n
   ▼
Orders
   │
   │ 1:n
   ▼
Order Items
   │
   │ n:1
   ▼
Products
Unser Testfall ist zunächst bewusst einfach:
Ein Kunde kauft ein Produkt. Cypress führt den Kauf über die Benutzeroberfläche durch. Anschließend prüfen wir in der Datenbank, ob die Bestellung korrekt gespeichert wurde.
Damit haben wir zwei Perspektiven auf denselben Vorgang.
Die erste Perspektive ist die des Benutzers:
Browser
   │
   ├── Produkt auswählen
   ├── Warenkorb öffnen
   ├── Checkout
   └── Bestellung abschicken
Die zweite Perspektive ist die des Systems:
Datenbank
   │
   ├── Kunde
   ├── Bestellung
   ├── Bestellposition
   └── Produkt
Genau diese Kombination macht Datenbankprüfungen in bestimmten Cypress-Tests interessant.
Warum überhaupt in die Datenbank schauen?
Bevor wir uns mit der technischen Umsetzung beschäftigen, sollten wir uns fragen, welchen Mehrwert ein Datenbankzugriff überhaupt bietet.
Ein klassischer E2E-Test könnte nach dem Checkout einfach prüfen:
cy.contains('Bestellung erfolgreich').should('be.visible');Das beantwortet eine wichtige Frage:
Hat der Benutzer den erwarteten Zustand in der Oberfläche erreicht?
Es beantwortet aber nicht zwangsläufig alle Fragen über die Persistenz. Angenommen, das Backend gibt nach dem Erstellen einer Bestellung die Bestätigungsseite zurück, obwohl beispielsweise die Bestellung mit einem falschen Betrag gespeichert wurde.
Ein reiner UI-Test könnte diesen Fehler unter Umständen nicht erkennen. Eine zusätzliche Datenbankprüfung könnte dagegen feststellen:
UI:
"Bestellung erfolgreich"

Datenbank:
total = 39.90

Erwartet:
total = 29.90
Damit können wir Fehler finden, die auf der Oberfläche zunächst nicht sichtbar sind.
Das bedeutet allerdings nicht, dass wir ab jetzt jeden Cypress-Test mit SQL-Abfragen versehen sollten.
Im Gegenteil.
Ein Datenbankzugriff erhöht die technische Kopplung unseres Tests. Wir müssen Datenbankverbindungen konfigurieren, Testdaten verwalten und darauf achten, dass unsere Tests nicht voneinander abhängig werden.
Deshalb sollte die Frage nicht lauten:
„Wie können wir in jedem Cypress-Test die Datenbank prüfen?“
Sondern:
„Welche Information können wir über die Benutzeroberfläche nicht sinnvoll überprüfen und benötigen deshalb eine zusätzliche Datenquelle?“
Cypress und Datenbanken – das grundlegende Prinzip
Cypress führt unsere Tests in einer Browser-Umgebung aus. Eine Datenbankverbindung gehört dagegen normalerweise nicht in den Browser. Wir wollen also nicht versuchen, aus dem Browser heraus direkt eine PostgreSQL- oder MySQL-Verbindung aufzubauen. Stattdessen nutzen wir die Node.js-Seite von Cypress.
Vereinfacht sieht die Architektur so aus:
┌──────────────────────┐
│      Cypress         │
│                      │
│  Browser-Test        │
│  cy.visit()          │
│  cy.get()            │
│  cy.click()          │
└──────────┬───────────┘
           │
           │ cy.task()
           ▼
┌──────────────────────┐
│       Node.js        │
│                      │
│ Datenbankverbindung  │
│ SQL ausführen        │
└──────────┬───────────┘
           │
           │ SQL
           ▼
┌──────────────────────┐
│      Datenbank       │
│                      │
│ PostgreSQL / MySQL   │
└──────────────────────┘
Die zentrale Funktion hierfür ist cy.task().
Damit können wir aus unserem Cypress-Test eine Aufgabe auf der Node.js-Seite ausführen lassen.
Das ist besonders praktisch, weil wir dort Datenbanktreiber und andere Node.js-Bibliotheken verwenden können.
cy.task() als Brücke zur Datenbank
Schauen wir uns zunächst ein vereinfachtes Beispiel an.
Wir definieren einen Task:
cy.task('dbQuery', {
    query: 'SELECT * FROM products'
});
Cypress führt diesen Task nicht im Browser aus.
Stattdessen wird die Aufgabe an den Node.js-Prozess übergeben, der für die Cypress-Konfiguration verwendet wird. Dort können wir beispielsweise mit einem PostgreSQL-Treiber eine Verbindung zur Datenbank herstellen.
Eine mögliche Struktur sieht vereinfacht so aus:
const { defineConfig } = require('cypress');
const { Client } = require('pg');

module.exports = defineConfig({
    e2e: {
        setupNodeEvents(on, config) {
            on('task', {
                async dbQuery({ query, values }) {
                    const client = new Client({
                        connectionString: process.env.DATABASE_URL
                    });

                    await client.connect();

                    try {
                        const result = await client.query(
                            query,
                            values
                        );

                        return result.rows;
                    } finally {
                        await client.end();
                    }
                }
            });

            return config;
        }
    }
});
Damit können wir aus einem Test heraus eine SQL-Abfrage ausführen:
cy.task('dbQuery', {
    query: 'SELECT * FROM products'
}).then((products) => {
    expect(products).to.have.length.greaterThan(0);
});
Die genaue Konfiguration hängt natürlich davon ab, welche Datenbank und welchen Treiber wir verwenden.
Das grundlegende Prinzip bleibt aber gleich:
Cypress Test
    │
    │ cy.task()
    ▼
Node.js Task
    │
    │ SQL
    ▼
Datenbank
    │
    │ Ergebnis
    ▼
Cypress Assertion
PostgreSQL mit Cypress verwenden
Für unseren Shop nehmen wir als Beispiel PostgreSQL.
Wir können einen passenden Node.js-Treiber installieren:
npm install pgAnschließend konfigurieren wir unseren Datenbankzugriff. Wichtig ist dabei, dass Zugangsdaten nicht direkt im Testcode stehen.
Wir wollen also nicht:
const password = 'super-secret-password';im Repository finden.
Stattdessen verwenden wir Umgebungsvariablen:
DATABASE_URL=postgres://user:password@localhost:5432/shopoder entsprechende einzelne Variablen für Host, Port, Benutzername und Passwort. Die Testumgebung sollte dabei eine eigene Datenbank verwenden. Ein Cypress-Test sollte möglichst nicht gegen die produktive Datenbank laufen.
Das klingt offensichtlich, ist aber eine wichtige Grenze:
Development
     │
     ├── Cypress
     │
     └── Test-Datenbank

CI
     │
     ├── Cypress
     │
     └── CI-Test-Datenbank

Production
     │
     └── KEINE Cypress-Testdatenbankzugriffe
Gerade wenn unsere Tests Daten löschen oder verändern, ist eine saubere Trennung entscheidend.
Das erste Produkt für unseren Shop anlegen
Bevor wir eine Bestellung durchführen können, benötigen wir ein Produkt. Wir könnten dieses Produkt über die Benutzeroberfläche anlegen. Für unseren E2E-Test wäre das aber nicht unbedingt sinnvoll. Wenn wir eigentlich den Checkout testen wollen, möchten wir nicht zuerst durch einen kompletten Produktanlageprozess navigieren.
Wir können das Produkt stattdessen als Testdaten vorbereiten.
Beispielsweise:
INSERT INTO products (
    name,
    price,
    stock
)
VALUES (
    'Playwright T-Shirt',
    29.90,
    10
);
In Cypress können wir daraus einen eigenen Task machen.
Zum Beispiel:
cy.task('dbQuery', {
    query: `
        INSERT INTO products (
            name,
            price,
            stock
        )
        VALUES ($1, $2, $3)
        RETURNING id
    `,
    values: [
        'Playwright T-Shirt',
        29.90,
        10
    ]
}).then((result) => {
    expect(result[0].id).to.exist;
});
Wir verwenden dabei Parameter statt Werte direkt in den SQL-String einzubauen.
Das ist nicht nur sauberer, sondern verhindert auch typische Probleme bei SQL-Injection und bei Sonderzeichen in Testdaten.
Testdaten sollten reproduzierbar sein
Ein häufiger Fehler bei Datenbanktests ist die Verwendung von Daten, die bereits vorhanden sein müssen.
Ein Test wie:
cy.task('dbQuery', {
    query: `
        SELECT *
        FROM products
        WHERE name = 'Playwright T-Shirt'
    `
});
funktioniert vielleicht auf dem eigenen Rechner.
- Aber was passiert, wenn der Test morgen erneut läuft?
- Oder wenn mehrere Tests gleichzeitig laufen?
- Oder wenn jemand das Produkt zwischenzeitlich löscht?
Wir sollten Tests möglichst unabhängig voneinander machen. Eine Möglichkeit besteht darin, für Testdaten eindeutige Werte zu erzeugen.
Zum Beispiel:
const testId = Date.now();

const productName = `Playwright T-Shirt ${testId}`;
Dann entsteht beispielsweise:
Playwright T-Shirt 1727359234567Noch besser ist es, eine eindeutige Test-ID bewusst als Teil unserer Testdaten zu behandeln.
const testRunId = Cypress.env('testRunId');Damit können wir Daten später gezielt wiederfinden und löschen.
Der eigentliche E2E-Test
Jetzt kommen wir zu dem Teil, für den wir Cypress eigentlich einsetzen wollen: der Benutzerinteraktion.
Wir öffnen unseren Shop:
cy.visit('/shop');Anschließend suchen wir unser Produkt und legen es in den Warenkorb:
cy.contains(productName)
    .parents('[data-cy=product]')
    .within(() => {
        cy.get('[data-cy=add-to-cart]').click();
    });
Danach öffnen wir den Warenkorb:
cy.get('[data-cy=cart]').click();Und gehen zum Checkout:
cy.get('[data-cy=checkout]').click();Der Kunde gibt seine Daten ein:
cy.get('[data-cy=email]')
    .type('max@example.com');

cy.get('[data-cy=firstname]')
    .type('Max');

cy.get('[data-cy=lastname]')
    .type('Mustermann');
Anschließend wird die Bestellung abgeschickt:
cy.get('[data-cy=submit-order]')
    .click();
Jetzt prüfen wir zunächst die Oberfläche:
cy.contains('Bestellung erfolgreich')
    .should('be.visible');
Bis hierhin ist das ein ganz normaler Cypress-E2E-Test.
Und jetzt schauen wir in die Datenbank
Jetzt kommt unser zusätzlicher Check. Wir wollen wissen, ob die Bestellung tatsächlich korrekt gespeichert wurde. Dazu können wir zunächst nach der Bestellung suchen.
Beispielsweise:
cy.task('dbQuery', {
    query: `
        SELECT
            id,
            status,
            total
        FROM orders
        WHERE customer_id = (
            SELECT id
            FROM customers
            WHERE email = $1
        )
        ORDER BY created_at DESC
        LIMIT 1
    `,
    values: ['max@example.com']
}).then((orders) => {
    expect(orders).to.have.length(1);

    expect(orders[0].status)
        .to.equal('NEW');

    expect(Number(orders[0].total))
        .to.equal(29.90);
});
Jetzt prüfen wir also zwei unterschiedliche Ebenen.
Die UI bestätigt:
Bestellung erfolgreichDie Datenbank bestätigt:
Order vorhanden
Status = NEW
Total = 29.90
Unser Test überprüft damit nicht nur den sichtbaren Zustand, sondern auch die Persistenz.
Die gesamte Bestellung prüfen
Noch interessanter wird es, wenn wir nicht nur die Bestellung selbst prüfen.
Eine Bestellung besteht schließlich aus mehreren Informationen.
Wir wollen beispielsweise wissen:
Bestellung
├── Kunde
├── Status
├── Gesamtbetrag
└── Positionen
    ├── Produkt
    ├── Menge
    └── Preis
Dafür können wir einen SQL-Join verwenden.
SELECT
    o.id AS order_id,
    o.status,
    o.total,
    c.email,
    p.name,
    oi.quantity,
    oi.price
FROM orders o
JOIN customers c
    ON c.id = o.customer_id
JOIN order_items oi
    ON oi.order_id = o.id
JOIN products p
    ON p.id = oi.product_id
WHERE c.email = $1
ORDER BY o.created_at DESC
LIMIT 1;
Im Cypress-Test können wir anschließend mehrere Eigenschaften prüfen:
cy.task('dbQuery', {
    query: `
        SELECT
            o.id AS order_id,
            o.status,
            o.total,
            c.email,
            p.name,
            oi.quantity,
            oi.price
        FROM orders o
        JOIN customers c
            ON c.id = o.customer_id
        JOIN order_items oi
            ON oi.order_id = o.id
        JOIN products p
            ON p.id = oi.product_id
        WHERE c.email = $1
        ORDER BY o.created_at DESC
        LIMIT 1
    `,
    values: ['max@example.com']
}).then((orders) => {

    expect(orders).to.have.length(1);

    const order = orders[0];

    expect(order.email)
        .to.equal('max@example.com');

    expect(order.name)
        .to.equal(productName);

    expect(order.quantity)
        .to.equal(1);

    expect(Number(order.price))
        .to.equal(29.90);

    expect(Number(order.total))
        .to.equal(29.90);

    expect(order.status)
        .to.equal('NEW');
});
Damit haben wir einen vollständigen Ablauf:
Testdaten erzeugen
        ↓
Shop öffnen
        ↓
Produkt auswählen
        ↓
Warenkorb
        ↓
Checkout
        ↓
Bestellung abschicken
        ↓
UI prüfen
        ↓
Datenbank prüfen
Das ist ein sehr typischer Anwendungsfall für einen kombinierten Cypress- und Datenbanktest.
Testdaten über die Datenbank vorbereiten
Der Datenbankzugriff ist aber nicht nur für Assertions interessant. Ein noch wichtigerer Anwendungsfall ist das Vorbereiten von Testdaten. Stellen wir uns vor, wir möchten testen, wie ein bestehender Kunde seine Bestellungen im Kundenkonto sieht. Der Kunde soll bereits fünf Bestellungen besitzen. Wir könnten diese fünf Bestellungen jedes Mal über die Benutzeroberfläche anlegen.
Das wäre ungefähr:
Login
  ↓
Produkt suchen
  ↓
Warenkorb
  ↓
Checkout
  ↓
Bestellung
  ↓
Zurück zum Shop
  ↓
Neue Bestellung
  ↓
...
Das wäre für einen Test, der eigentlich nur die Bestellübersicht prüfen soll, unnötig aufwendig. Wir können die Ausgangssituation stattdessen über Testdaten herstellen.
Datenbank
   │
   ├── Kunde anlegen
   ├── Produkt anlegen
   ├── Bestellung 1
   ├── Bestellung 2
   ├── Bestellung 3
   ├── Bestellung 4
   └── Bestellung 5
            │
            ▼
         Cypress
            │
            ▼
       Kundenkonto
Der Browser-Test kann sich dann auf das konzentrieren, was wir tatsächlich testen wollen.
Datenbankzugriff in beforeEach()
Für wiederkehrende Testdaten können wir beforeEach() verwenden.
Beispielsweise:
beforeEach(() => {
    cy.task('dbQuery', {
        query: `
            INSERT INTO products (
                name,
                price,
                stock
            )
            VALUES ($1, $2, $3)
        `,
        values: [
            'Playwright T-Shirt',
            29.90,
            10
        ]
    });
});
Danach startet jeder Test mit einem definierten Produkt.
Das kann sinnvoll sein. Wir sollten aber aufpassen, dass wir beforeEach() nicht mit immer komplexeren Datenbankoperationen füllen. Wenn dort plötzlich zwanzig SQL-Statements stehen, ist der Test zwar technisch reproduzierbar, aber schwer zu verstehen.
Dann lohnt es sich, die Testdatenlogik zu kapseln.
Zum Beispiel:
function createProduct(product) {
    return cy.task('dbQuery', {
        query: `
            INSERT INTO products (
                name,
                price,
                stock
            )
            VALUES ($1, $2, $3)
            RETURNING id
        `,
        values: [
            product.name,
            product.price,
            product.stock
        ]
    });
}
Der Test wird dadurch lesbarer:
createProduct({
    name: 'Playwright T-Shirt',
    price: 29.90,
    stock: 10
});
Wir sehen sofort, was vorbereitet wird.
Die Details der Datenbank bleiben im Helper.
Testdaten wieder aufräumen
Wenn wir Testdaten erzeugen, müssen wir uns auch Gedanken über deren Lebenszyklus machen.
Ein Test, der jeden Durchlauf neue Kunden, Produkte und Bestellungen erzeugt, kann unsere Datenbank schnell mit Testdaten füllen.
Deshalb sollten wir eine Strategie für Cleanup definieren.
Eine einfache Möglichkeit ist das Löschen über eine eindeutige Test-ID:
DELETE FROM orders
WHERE test_run_id = $1;
Anschließend können beispielsweise abhängige Daten gelöscht werden. Die konkrete Reihenfolge hängt natürlich von den Foreign-Key-Beziehungen und der Datenbankkonfiguration ab.
Wichtig ist vor allem:
Ein Test sollte möglichst genau wissen, welche Daten er angelegt hat und welche Daten er wieder entfernen darf.
Wir sollten nicht einfach am Ende eines Tests pauschal Folgendes ausführen:
DELETE FROM orders;Das wäre spätestens bei parallel laufenden Tests problematisch.
Parallel laufende Cypress-Tests
Cypress-Tests werden häufig parallel ausgeführt, insbesondere in CI-Systemen.
Dann kann folgendes Problem entstehen:
Test A
   │
   ├── Produkt "T-Shirt" anlegen
   │
   └── Bestellung erzeugen

Test B
   │
   ├── Produkt "T-Shirt" anlegen
   │
   └── Bestellung erzeugen
Wenn beide Tests dieselben Daten verwenden, wissen wir möglicherweise nicht mehr, welcher Datensatz zu welchem Test gehört. Noch problematischer wird es beim Cleanup.
Test A löscht möglicherweise Daten, die Test B noch benötigt. Deshalb sollten Testdaten voneinander isoliert sein.
Eine einfache Strategie ist eine eindeutige Test-ID:
const testRunId = `${Date.now()}-${Cypress.currentTest.title}`;Diese ID kann Bestandteil der Testdaten werden.
Product
--------
id
name
test_run_id
Dann können wir später gezielt nach unseren Daten suchen:
SELECT *
FROM products
WHERE test_run_id = $1;
Und ebenso gezielt aufräumen.
Je größer das Projekt wird, desto wichtiger wird eine durchdachte Testdatenstrategie.
API, UI und Datenbank kombinieren
Ein Datenbankzugriff ist nicht die einzige Möglichkeit, Testdaten vorzubereiten.
In modernen Webanwendungen haben wir häufig mindestens drei interessante Ebenen:
             ┌─────────────┐
             │     UI      │
             │   Cypress   │
             └──────┬──────┘
                    │
             ┌──────▼──────┐
             │     API     │
             └──────┬──────┘
                    │
             ┌──────▼──────┐
             │ Datenbank   │
             └─────────────┘
Jede Ebene kann für unterschiedliche Aufgaben sinnvoll sein. Die UI ist ideal, wenn wir Benutzerinteraktionen testen wollen. Die API ist häufig praktisch, wenn wir Daten schnell erzeugen oder einen Backend-Zustand herstellen möchten. Die Datenbank kann sinnvoll sein, wenn wir einen Zustand direkt prüfen oder Testdaten besonders gezielt vorbereiten müssen.
Ein Beispiel:
API:
Kunde anlegen
   ↓
Datenbank:
Produkt vorbereiten
   ↓
UI:
Checkout durchführen
   ↓
Datenbank:
Bestellung prüfen
Damit vermeiden wir, dass jeder Test alle Vorbereitungen über die UI durchführen muss.
Beispiel: Kunde über die API vorbereiten
Angenommen, unser Shop besitzt eine API:
POST /api/customersDann können wir einen Kunden beispielsweise über cy.request() anlegen:
cy.request('POST', '/api/customers', {
    email: 'max@example.com',
    firstname: 'Max',
    lastname: 'Mustermann'
});
Danach testen wir die eigentliche Benutzerinteraktion über die UI.
Das kann beispielsweise so aussehen:
API
 │
 └── Kunde vorbereiten
          ↓
        Cypress
          │
          ├── Login
          ├── Produkt auswählen
          ├── Checkout
          └── Bestellung
          ↓
      Datenbank
          │
          └── Bestellung prüfen
Damit nutzen wir für jede Aufgabe die passende Schnittstelle.
Wann sollten wir die Datenbank direkt verwenden?
Hier liegt ein wichtiger Punkt.
Nur weil wir technisch auf die Datenbank zugreifen können, heißt das nicht automatisch, dass wir es tun sollten.
Nehmen wir einen Login-Test.
Wir könnten nach dem Login in der Datenbank prüfen:
SELECT *
FROM users
WHERE email = 'max@example.com';
Aber was testen wir damit eigentlich?
Wenn unser Test die Benutzeranmeldung prüfen soll, sind die relevanten Fragen eher:
- Kann der Benutzer das Login-Formular ausfüllen?
- Wird das Login akzeptiert?
- Wird der Benutzer weitergeleitet?
- Sieht er sein Konto?
- Wird ein falsches Passwort abgelehnt?
Dafür benötigen wir keine Datenbankprüfung. Ein Datenbankzugriff würde hier möglicherweise nur zusätzliche technische Kopplung erzeugen. Anders sieht es bei einem Test aus, bei dem die Persistenz selbst relevant ist.
Zum Beispiel:
Wird eine Bestellung mit dem korrekten Gesamtbetrag gespeichert?
Hier kann eine Datenbankprüfung einen echten zusätzlichen Informationsgewinn liefern.
UI-Zustand und Datenbankzustand sind nicht dasselbe
Ein wichtiger Punkt wird schnell übersehen:
Die Datenbank ist nicht automatisch die Wahrheit über den Zustand der Benutzeroberfläche.
Unsere Anwendung kann beispielsweise Daten cachen.
Oder ein Backend-Prozess kann asynchron arbeiten.
Stellen wir uns vor, der Checkout funktioniert so:
UI
 │
 │ Bestellung absenden
 ▼
Backend
 │
 │ Bestellung anlegen
 ▼
Queue
 │
 │ asynchron
 ▼
Datenbank / weiterer Service
Dann muss ein sofortiger Datenbank-Check nicht zwangsläufig erfolgreich sein.
Wir sollten also nicht einfach:
cy.get('[data-cy=submit-order]').click();

cy.task('dbQuery', ...);
als feste Annahme betrachten.
Je nach Architektur müssen wir auf einen fachlich relevanten Zustand warten.
Dabei ist ein pauschales:
cy.wait(5000);
meist nicht die beste Lösung.
Besser ist es, auf einen konkreten Zustand zu warten.
Beispielsweise über einen API-Status oder eine gezielte Wiederholung einer Abfrage.
Datenbankabfragen wiederholen
Wenn ein Backend die Daten asynchron verarbeitet, kann eine Datenbankabfrage zunächst noch kein Ergebnis liefern.
Das könnte vereinfacht so aussehen:
t = 0
UI: Bestellung abgeschickt

t = 100 ms
DB: Bestellung noch nicht vorhanden

t = 500 ms
DB: Bestellung noch nicht vorhanden

t = 900 ms
DB: Bestellung vorhanden
In solchen Fällen brauchen wir eine fachliche Synchronisation. Eine Möglichkeit besteht darin, einen Cypress-Task so zu gestalten, dass er eine bestimmte Bedingung innerhalb eines definierten Zeitraums abwartet. Wichtig ist dabei, dass wir einen echten Zustand prüfen und nicht einfach eine beliebige Wartezeit einbauen.
Der Unterschied ist:
cy.wait(5000);gegen:
Warte, bis Bestellung mit ID X existiertDie zweite Variante beschreibt genau das, was wir tatsächlich benötigen.
MySQL und andere Datenbanken
Das Prinzip ist nicht auf PostgreSQL beschränkt.
Auch MySQL oder MariaDB können über entsprechende Node.js-Treiber angebunden werden.
Das Architekturprinzip bleibt:
Cypress
   │
   │ cy.task()
   ▼
Node.js
   │
   │ Datenbanktreiber
   ▼
MySQL / MariaDB / PostgreSQL / ...
Wir müssen also nicht für jede Datenbank eine komplett andere Cypress-Strategie entwickeln.
Was sich ändert, sind hauptsächlich:
- verwendeter Node.js-Treiber
- Connection-String
- SQL-Dialekt
- Transaktionsverhalten
- Datenbankkonfiguration
Der Cypress-Teil kann dabei weitgehend gleich bleiben.
SQL nicht überall im Test verteilen
Ein Test sollte möglichst nicht so aussehen:
cy.task('dbQuery', {
    query: 'SELECT ...'
});

cy.task('dbQuery', {
    query: 'INSERT ...'
});

cy.task('dbQuery', {
    query: 'UPDATE ...'
});

cy.task('dbQuery', {
    query: 'DELETE ...'
});
Wenn wir das an vielen Stellen unseres Projekts machen, wird die Datenbanklogik schnell schwer wartbar.
Besser ist eine Abstraktion.
Zum Beispiel:
function createProduct(product) {
    // Datenbankoperation
}

function findOrderByCustomer(email) {
    // Datenbankoperation
}

function deleteTestData(testRunId) {
    // Datenbankoperation
}
Unser Test kann dann fachlich formuliert werden:
createProduct({
    name: 'Playwright T-Shirt',
    price: 29.90,
    stock: 10
});

cy.visit('/shop');

...

findOrderByCustomer('max@example.com')
    .then((order) => {
        expect(order.status).to.equal('NEW');
    });
Der Test beschreibt damit den fachlichen Ablauf.
Die Details der SQL-Abfragen liegen an einer zentralen Stelle.
Ein vollständiger Cypress-Test
Fassen wir unseren Shop-Test einmal zusammen.
Wir bereiten ein Produkt vor, führen den Kauf über die UI durch und prüfen anschließend die Datenbank.
Vereinfacht könnte das so aussehen:
describe('Checkout', () => {

    const customerEmail = 'max@example.com';

    beforeEach(() => {
        cy.task('dbQuery', {
            query: `
                INSERT INTO products (
                    name,
                    price,
                    stock
                )
                VALUES ($1, $2, $3)
            `,
            values: [
                'Playwright T-Shirt',
                29.90,
                10
            ]
        });
    });

    it('legt eine Bestellung korrekt an', () => {

        cy.visit('/shop');

        cy.contains('Playwright T-Shirt')
            .parents('[data-cy=product]')
            .within(() => {
                cy.get('[data-cy=add-to-cart]')
                    .click();
            });

        cy.get('[data-cy=cart]')
            .click();

        cy.get('[data-cy=checkout]')
            .click();

        cy.get('[data-cy=email]')
            .type(customerEmail);

        cy.get('[data-cy=firstname]')
            .type('Max');

        cy.get('[data-cy=lastname]')
            .type('Mustermann');

        cy.get('[data-cy=submit-order]')
            .click();

        cy.contains('Bestellung erfolgreich')
            .should('be.visible');

        cy.task('dbQuery', {
            query: `
                SELECT
                    o.id,
                    o.status,
                    o.total,
                    c.email,
                    p.name,
                    oi.quantity
                FROM orders o
                JOIN customers c
                    ON c.id = o.customer_id
                JOIN order_items oi
                    ON oi.order_id = o.id
                JOIN products p
                    ON p.id = oi.product_id
                WHERE c.email = $1
                ORDER BY o.created_at DESC
                LIMIT 1
            `,
            values: [customerEmail]
        }).then((orders) => {

            expect(orders).to.have.length(1);

            const order = orders[0];

            expect(order.status)
                .to.equal('NEW');

            expect(order.email)
                .to.equal(customerEmail);

            expect(order.name)
                .to.equal('Playwright T-Shirt');

            expect(order.quantity)
                .to.equal(1);

            expect(Number(order.total))
                .to.equal(29.90);
        });
    });
});
Das Beispiel zeigt den grundsätzlichen Aufbau.
In einem echten Projekt würden wir die Datenbankoperationen wahrscheinlich noch stärker kapseln und insbesondere die Testdaten-Isolation sauber lösen.
Was passiert, wenn der Datenbank-Check fehlschlägt?
Jetzt wird unser zusätzlicher Check besonders interessant.
Angenommen, Cypress zeigt:
Bestellung erfolgreichDie Datenbank enthält aber:
status = NEW
total  = 39.90
obwohl das Produkt nur 29,90 Euro kostet.
Unser Test schlägt fehl. Das ist genau das, was wir erreichen wollten.
Wir wissen nun:
Benutzeroberfläche
        │
        └── Bestellung erfolgreich

Persistenz
        │
        └── Gesamtbetrag falsch
Damit haben wir einen konkreten Hinweis auf einen Fehler in der Anwendung.
Wichtig ist allerdings:
Der Cypress-Test hat den Fehler gefunden. Er kennt nicht automatisch die Ursache.
Die Ursache könnte beispielsweise liegen in:
- falscher Berechnung im Backend
- falschem Mapping
- fehlerhaften Daten
- falschem SQL
- Rundungsproblemen
- Race Conditions
- einem Fehler bei der Preisübertragung
Der Datenbank-Check liefert also eine zusätzliche Beobachtungsebene.
Er ersetzt keine Ursachenanalyse.
Datenbanktests sind nicht automatisch E2E-Tests
Hier lohnt sich eine klare Abgrenzung.
Wenn wir ausschließlich eine SQL-Abfrage ausführen:
SELECT *
FROM products
WHERE id = 123;
testen wir keine Benutzerinteraktion.
Wir testen einen Zustand der Datenbank.
Wenn wir dagegen:
Browser öffnen
    ↓
Produkt auswählen
    ↓
Checkout
    ↓
Bestellung abschicken
    ↓
Datenbank prüfen
durchführen, haben wir einen echten E2E-Test mit einer zusätzlichen Persistenzprüfung.
Diese Unterscheidung ist wichtig.
Denn nicht jede Datenbankprüfung muss durch Cypress laufen.
Wann ein Datenbanktest sinnvoller ist
Stellen wir uns beispielsweise eine Funktion vor, die aus mehreren Tabellen Daten zusammenführt.
Dafür benötigen wir vielleicht überhaupt keinen Browser.
Ein Integrationstest auf Backend-Ebene kann dafür deutlich direkter sein.
Zum Beispiel:
API
 │
 ▼
Service
 │
 ▼
Repository
 │
 ▼
Datenbank
Hier können wir direkt prüfen, ob unser Backend die richtigen Daten schreibt.
Der Browser wäre für diesen Test nur zusätzlicher Ballast.
Cypress ist besonders interessant, wenn wir tatsächlich die Verbindung zwischen Benutzeraktion und Systemzustand prüfen wollen.
Drei verschiedene Testfragen
Wir können unsere Tests deshalb anhand der Frage unterscheiden.
Frage 1: Funktioniert die Benutzerinteraktion?
Kunde klickt "Bestellen"
        ↓
Bestellbestätigung erscheint
- Cypress E2E-Test
Frage 2: Wird die Bestellung korrekt gespeichert?
Order
├── customer_id
├── status
├── total
└── order_items
- Datenbank-/Integrationstest oder zusätzlicher DB-Check
Frage 3: Was passiert bei 10.000 gleichzeitigen Bestellungen?
1.000 Benutzer
      ↓
10.000 Requests
      ↓
Backend
      ↓
Datenbank
- Last- und Performance-Testing
Das sind drei unterschiedliche Testfragen. Cypress kann Teil der Antwort auf die erste und in Kombination auch auf die zweite Frage sein. Für die dritte Frage ist es nicht das passende Werkzeug.
Der Datenbankzugriff als Werkzeug für Testdaten
Ein besonders praktischer Einsatz bleibt deshalb die Vorbereitung von Testdaten.
Nehmen wir an, wir möchten einen Test für einen Shop durchführen, bei dem das Lager leer ist.
Wir benötigen:
Produkt
Name: Playwright T-Shirt
Preis: 29,90 €
Stock: 0
Diese Situation können wir gezielt erzeugen:
INSERT INTO products (
    name,
    price,
    stock
)
VALUES (
    'Playwright T-Shirt',
    29.90,
    0
);
Danach öffnen wir den Shop:
cy.visit('/shop');und prüfen:
cy.contains('Nicht verfügbar').should('be.visible');Hier ist der Datenbankzugriff gar nicht unbedingt eine zusätzliche Assertion.
Er dient dazu, einen definierten Ausgangszustand herzustellen.
Das ist häufig einer der größten praktischen Vorteile.
Datenbank als Setup - Nicht als Testziel
Wir können deshalb zwischen zwei grundlegenden Einsatzarten unterscheiden.
1. Datenbank als Setup
Datenbank
    ↓
Testdaten erzeugen
    ↓
Cypress
    ↓
UI testen
Beispiel:
Erzeuge einen Kunden mit zehn Bestellungen.
2. Datenbank als Assertion
Cypress
    ↓
Benutzeraktion
    ↓
Backend
    ↓
Datenbank
    ↓
Cypress Assertion
Beispiel:
Prüfe, ob die Bestellung mit dem richtigen Betrag gespeichert wurde.
Beide Varianten können sinnvoll sein.
Die erste Variante ist häufig weniger problematisch, weil wir damit nur den Ausgangszustand vorbereiten.
Bei der zweiten Variante sollten wir genauer prüfen, ob die Datenbankprüfung wirklich einen zusätzlichen Mehrwert liefert.
Was wir vermeiden sollten
Ein Datenbankzugriff kann unsere Tests deutlich mächtiger machen.
Er kann sie aber auch unnötig kompliziert machen.
Ein typisches Anti-Pattern wäre beispielsweise ein Test, der jeden einzelnen UI-Schritt anschließend mit SQL überprüft:
Login
  ↓
DB prüfen

Produkt öffnen
  ↓
DB prüfen

Warenkorb
  ↓
DB prüfen

Adresse eingeben
  ↓
DB prüfen

Checkout
  ↓
DB prüfen

Bestellung
  ↓
DB prüfen
Damit testen wir irgendwann mehr unsere Datenbankstruktur als das Benutzerverhalten.
Ein E2E-Test sollte in erster Linie die fachliche Benutzerinteraktion abbilden.
Der Datenbankzugriff sollte gezielt eingesetzt werden.
Keine internen Implementierungsdetails unnötig testen
Angenommen, unser Shop speichert heute:
orders
order_items
und nach einer späteren Änderung werden Bestellungen anders persistiert.
Wenn sich das Verhalten für den Benutzer nicht verändert hat, sollten möglichst nicht zehn UI-Tests fehlschlagen, nur weil sich das interne Datenmodell geändert hat.
Genau hier entsteht eine wichtige Kopplung:
Cypress Test
     │
     ├── UI
     │
     └── Datenbankstruktur
Je mehr wir direkt auf Tabellen und Spalten zugreifen, desto stärker hängt unser Test von der internen Implementierung ab. Das kann sinnvoll sein, wenn genau diese Persistenz relevant ist.
Es kann aber auch unnötige Wartung verursachen.
Eine gute Grenze finden
Für unseren Shop können wir beispielsweise folgende Strategie verwenden:
┌──────────────────────────────────────────┐
│ Cypress E2E                              │
│                                          │
│ Benutzerverhalten                        │
│ - Produkt auswählen                      │
│ - Warenkorb                              │
│ - Checkout                               │
│ - Bestellung abschicken                  │
│ - Bestätigung anzeigen                   │
└────────────────────┬─────────────────────┘
                     │
                     │ gezielte Prüfung
                     ▼
┌──────────────────────────────────────────┐
│ Datenbank                                 │
│                                          │
│ - Bestellung existiert                  │
│ - Status korrekt                         │
│ - Betrag korrekt                         │
│ - Position vorhanden                     │
└──────────────────────────────────────────┘
Wir prüfen also nicht alles doppelt.
Wir prüfen gezielt die Stellen, an denen die Datenbank zusätzliche Informationen liefert.
Sicherheit und Zugangsdaten
Ein Datenbankzugriff in Cypress bedeutet auch, dass unser Testprojekt Zugangsdaten benötigt.
Diese gehören nicht in das Repository.
Nicht:
const config = {
    user: 'cypress',
    password: 'my-password'
};
Sondern beispielsweise über Umgebungsvariablen:
DATABASE_URL=...oder über die jeweilige CI-Konfiguration.
Außerdem sollte der Datenbankbenutzer möglichst nur die Rechte besitzen, die für die Tests notwendig sind.
Ein Testbenutzer benötigt nicht automatisch vollständige Administrationsrechte.
Besonders wichtig ist die Umgebung:
Development DB
        │
        └── Cypress

Test DB
        │
        └── CI

Production DB
        │
        └── keine Testzugriffe
Je näher Tests an produktive Systeme kommen, desto wichtiger werden Schutzmechanismen.
Transaktionen als weiterer Baustein
Bei komplexeren Datenbanktests können Transaktionen interessant werden.
Eine Transaktion erlaubt es, mehrere Datenbankoperationen als zusammengehörige Einheit auszuführen.
Vereinfacht:
BEGIN
   │
   ├── Kunde anlegen
   ├── Produkt anlegen
   ├── Bestellung anlegen
   └── Position anlegen
   │
COMMIT
Oder bei einem Fehler:
BEGIN
   │
   ├── Kunde anlegen
   ├── Produkt anlegen
   └── Fehler
        │
        ▼
      ROLLBACK
Ob und wie wir Transaktionen für Cypress-Tests einsetzen können, hängt stark von unserer Anwendung und Datenbankarchitektur ab.
Insbesondere wenn Browseraktionen und Datenbankoperationen über getrennte Prozesse laufen, lässt sich nicht einfach eine Transaktion über den kompletten E2E-Test spannen.
Deshalb sollten wir Transaktionen nicht als universelle Cleanup-Lösung betrachten.
Ein praktischer Entscheidungsbaum
Wenn wir einen neuen Cypress-Test schreiben, können wir uns einige einfache Fragen stellen.
Was möchte ich testen?
        │
        ▼
Benutzerinteraktion?
        │
       Ja
        │
        ▼
     Cypress
        │
        ▼
Brauche ich zusätzliche
Informationen aus dem Backend?
        │
    ┌───┴───┐
   Nein     Ja
    │        │
    ▼        ▼
  UI-Test   API/DB prüfen
Für Testdaten können wir einen ähnlichen Weg gehen:
Welche Ausgangsdaten brauche ich?
        │
        ▼
Müssen sie über die UI
erzeugt werden?
        │
    ┌───┴───┐
   Ja      Nein
    │        │
    ▼        ▼
  UI      API/DB
Damit verhindern wir, dass jeder Test automatisch denselben Weg nimmt.
Best Practices für Cypress und Datenbanken
Aus unserem Shopsystem lassen sich einige Regeln ableiten.
1. Datenbankzugriffe gezielt einsetzen
Nicht jeder E2E-Test benötigt eine SQL-Abfrage.
Wir sollten prüfen, welchen zusätzlichen Informationsgewinn sie liefert.
2. Testdaten reproduzierbar erzeugen
Ein Test sollte möglichst genau wissen, welche Daten er benötigt.
Test starten
    ↓
Daten vorbereiten
    ↓
Test ausführen
    ↓
Ergebnis prüfen
    ↓
Daten bereinigen
3. Tests voneinander isolieren
Keine gemeinsam genutzten Testdaten, wenn sie vermeidbar sind.
Besonders bei paralleler Ausführung ist eine eindeutige Test-ID hilfreich.
4. SQL kapseln
Die SQL-Abfragen sollten nicht überall im Testcode verteilt werden.
Helpers oder eigene Datenbankfunktionen machen Tests lesbarer.
5. Zugangsdaten schützen
Keine Passwörter und Connection-Strings im Repository.
6. Keine Produktionsdatenbank verwenden
Testdaten gehören in eine Testumgebung.
7. Nicht unnötig auf interne Details testen
Je stärker der Test an Tabellen und Spalten gekoppelt ist, desto stärker hängt er von der internen Implementierung ab.
8. Auf echte Zustände warten
Bei asynchroner Verarbeitung sollten wir auf fachliche Zustände warten und nicht einfach lange Pausen einbauen.
9. API und Datenbank als Alternativen betrachten
Wenn die API Testdaten einfacher erzeugen kann, müssen wir nicht zwingend direkt auf die Datenbank zugreifen.
10. E2E-Tests nicht mit Datenbanktests verwechseln
Ein Test kann beide Ebenen kombinieren. Sie bleiben trotzdem unterschiedliche Testfragen.
Cypress, API oder Datenbank?
Zum Abschluss können wir die drei Ebenen noch einmal gegenüberstellen.
| Aufgabe | Geeignete Ebene |
|---|---|
| Benutzer klickt auf „Bestellen“ | Cypress |
| Checkout funktioniert | Cypress |
| Formularvalidierung | Cypress |
| API liefert korrekte Daten | API-Test |
| Kunde über API anlegen | API |
| Komplexe Testdaten erzeugen | API / Datenbank |
| Bestellung direkt prüfen | Datenbank / Integrationstest |
| Persistenz nach UI-Aktion prüfen | Cypress + Datenbank |
| Datenbankmodell testen | Datenbank-/Integrationstest |
| Viele gleichzeitige Benutzer | Performance-/Lasttest |
Es geht also nicht darum, Cypress möglichst viele Aufgaben übernehmen zu lassen.
Es geht darum, die passende Testebene für die jeweilige Fragestellung zu verwenden.
Unser Shopsystem als Gesamtbild
Unser Beispiel lässt sich am Ende so zusammenfassen:
                     Cypress
                        │
                        ▼
               ┌────────────────┐
               │    Webshop     │
               │                │
               │ Produkt        │
               │ Warenkorb      │
               │ Checkout       │
               └───────┬────────┘
                       │
                       ▼
               ┌────────────────┐
               │    Backend     │
               │                │
               │ Kunden         │
               │ Bestellungen   │
               │ Preise         │
               └───────┬────────┘
                       │
                       ▼
               ┌────────────────┐
               │   Datenbank    │
               │                │
               │ customers      │
               │ products       │
               │ orders         │
               │ order_items    │
               └────────────────┘
                       ▲
                       │
                    cy.task()
                       │
                       └──── Cypress
Cypress übernimmt dabei die Rolle des Benutzers.
Wir testen den Shop so, wie ein Benutzer ihn verwendet. Über cy.task() können wir zusätzlich mit der Node.js-Seite kommunizieren und dort Datenbankoperationen ausführen. Die Datenbank kann uns wiederum dabei helfen, Testdaten herzustellen oder Persistenz zu überprüfen.
Fazit: Cypress Tests mit Blick in die Datenbank
Cypress ist in erster Linie ein Werkzeug für das Testen von Webanwendungen aus Sicht des Benutzers. Das bedeutet aber nicht, dass wir auf die Benutzeroberfläche beschränkt sind. Über cy.task() können wir Aufgaben auf der Node.js-Seite ausführen und beispielsweise Datenbankabfragen durchführen.
Damit ergeben sich zwei besonders interessante Einsatzbereiche:
1. Testdaten vorbereiten

Datenbank
    ↓
definierter Ausgangszustand
    ↓
Cypress E2E-Test
und:
2. Persistenz prüfen

Cypress
    ↓
Benutzeraktion
    ↓
Backend
    ↓
Datenbank
    ↓
Cypress Assertion
Gerade unser Shopsystem zeigt, warum diese Kombination praktisch sein kann.
Wir können ein Produkt direkt für den Test vorbereiten, den Checkout realistisch über die Benutzeroberfläche durchführen und anschließend prüfen, ob die Bestellung tatsächlich korrekt persistiert wurde. Trotzdem sollten wir nicht jede Datenbankprüfung in einen Cypress-Test packen.
Ein direkter Datenbankzugriff macht einen Test stärker abhängig von der internen Datenstruktur. Außerdem können Datenbankzugriffe die Testarchitektur komplexer machen und bei parallelen Tests zusätzliche Anforderungen an die Testdaten-Isolation stellen.
Deshalb gilt auch hier:
Nicht die technische Möglichkeit entscheidet darüber, ob wir die Datenbank verwenden sollten. Entscheidend ist die Testfrage.
Wenn wir Benutzerverhalten testen wollen, ist Cypress eine passende Testebene. Wenn wir die API testen wollen, sollten wir die API direkt testen. Wenn wir Datenbanklogik oder Persistenz isoliert prüfen wollen, kann ein Integrationstest die passendere Lösung sein.
Und wenn wir wissen wollen, wie sich unser Shop unter hoher Last verhält, benötigen wir ein Performance- oder Lasttestwerkzeug. Cypress und die Datenbank müssen also keine Gegensätze sein.
Richtig eingesetzt können sie sich ergänzen:
              Teststrategie
                   │
       ┌───────────┼───────────┐
       ▼           ▼           ▼
      UI          API       Datenbank
       │           │           │
       └───────────┼───────────┘
                   ▼
              Gesamtsystem
Cypress muss dabei nicht alles testen. Es sollte genau das testen, wofür Browser-Automatisierung die passende Testebene ist – und die Datenbank dort ergänzen, wo sie uns eine zusätzliche, fachlich relevante Aussage ermöglicht.